La détection d’anomalies par IA en fabrication utilise les données historiques de production et de capteurs pour apprendre les profils de fonctionnement normal et repérer les changements inhabituels, même lorsque les mesures individuelles restent à l’intérieur de leurs limites d’alarme. Au lieu de programmer une règle pour chaque défaillance possible, les usines peuvent surveiller les relations entre les signaux. Le défi consiste à transformer ces constats en avertissements utiles sans créer davantage de fausses alertes.
Prenons l’exemple hypothétique d’une usine d’embouteillage de jus en Ontario. Leah, responsable de la fiabilité de l’usine, enquête sur une pompe de transfert qui a causé des interruptions de production intermittentes.
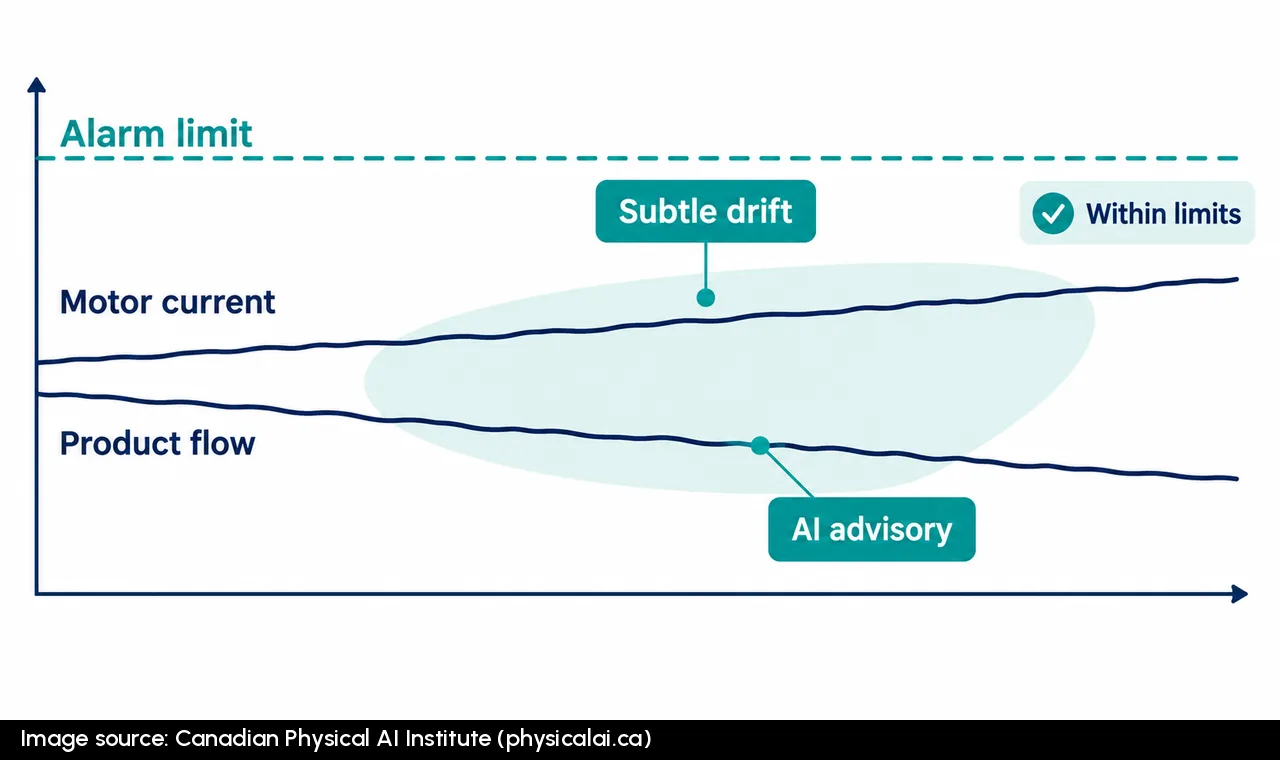
La pompe fonctionne dans les limites configurées. Le courant du moteur est acceptable, la pression de refoulement n’a pas déclenché d’alarme et le débit du produit demeure dans la plage permise. Pourtant, lorsqu’elle examine plusieurs quarts de travail ensemble, Leah remarque que la pompe consomme légèrement plus de courant pour acheminer légèrement moins de produit.
Une alarme conventionnelle d’API se déclenche lorsqu’une condition définie survient. Un détecteur d’anomalies par IA pourrait reconnaître que la pompe se comporte différemment de périodes comparables de fonctionnement sain, donnant à Leah l’occasion d’inspecter l’équipement avant une panne.
Le changement pourrait aussi refléter un changement de recette légitime, une viscosité différente du produit ou une dérive de l’instrument. Repérer un profil inhabituel n’est utile que si l’usine peut établir ce qu’il signifie et agir sans submerger les opérateurs.
Ce guide porte sur les données de capteurs industriels et les séries temporelles des équipements de procédé. La détection d’anomalies par image repose sur des images de caméra et exige un pipeline de données et une méthode de validation différents.
Comment l’IA repère les problèmes que les règles d’alarme fixes peuvent manquer
L’usine de Leah recueille déjà la plupart des renseignements nécessaires pour examiner le problème naissant de la pompe. Son API et son historien enregistrent le courant, la pression, le débit et les états de fonctionnement de la machine, mais l’interprétation de ces mesures détermine ce que l’usine peut détecter.
Une alarme conventionnelle évalue une condition configurée par un ingénieur. Par exemple, elle pourrait se déclencher lorsque le courant du moteur dépasse une valeur définie pendant une période précise.
Cette méthode fonctionne bien lorsque la condition indésirable et sa limite appropriée sont connues. Le contrôleur peut évaluer la condition de façon uniforme et déclencher une réponse établie. Toutefois, un problème de pompe en développement peut se manifester par un changement graduel de plusieurs mesures avant que l’une d’elles dépasse sa limite individuelle.
La recherche sur la surveillance statistique multivariée des procédés explique pourquoi l’évaluation des relations entre variables peut révéler des écarts de procédé que les mesures individuelles ne décrivent pas adéquatement.
La différence devient plus claire lorsqu’on compare les deux approches.
| Question | Règles d’alarme fixes API/SCADA | Détection d’anomalies par IA entraînée |
|---|---|---|
| Qu’examine-t-elle ? | Des mesures, états ou conditions précis | Des mesures, profils et relations appris à partir des données |
| Comment le comportement anormal est-il défini ? | Les ingénieurs configurent les limites et la logique | Un modèle établit le comportement attendu à partir de données de référence |
| Que détecte-t-elle bien ? | Les conditions dangereuses, inacceptables ou opérationnelles connues | Les combinaisons inhabituelles, les dérives graduelles et les profils de fonctionnement inconnus |
| Que peut-elle manquer ? | Les changements qui demeurent dans les limites configurées | Les défaillances invisibles dans les données disponibles ou les changements que le modèle considère à tort comme normaux |
| Quelle configuration est nécessaire ? | Conditions d’alarme, priorités, délais et réponses requises | Préparation des données, contexte de fonctionnement, configuration du modèle et politique d’alerte |
| Qui interprète le résultat ? | Un opérateur désigné qui suit une procédure de réponse à l’alarme | Un ingénieur, un opérateur ou un technicien désigné qui examine l’écart |
| Meilleure utilisation | Alarmes opérationnelles établies et fonctions de protection | Avertissements précoces, diagnostic et surveillance de l’état |
| Limite principale | Ne peut pas détecter les profils qui ne sont pas représentés dans sa logique | Peut confondre des changements opérationnels légitimes avec des défaillances |
Les deux approches sont complémentaires. Leah devrait conserver l’alarme de courant élevé de la pompe, puisqu’elle protège contre une condition définie, tandis que le modèle recherche des signes supplémentaires de dégradation.
Pourquoi la détection d’anomalies sans règles manuelles nécessite quand même des seuils
L’expression « détection d’anomalies sans seuils » peut créer des attentes trompeuses. Un détecteur entraîné calcule généralement à quel point le comportement actuel diffère des données de référence. Cette mesure peut être un score d’anomalie, une erreur de prédiction ou une erreur de reconstruction.
L’usine doit tout de même décider à quel moment l’écart mérite une attention. Leah pourrait exiger qu’un écart persiste pendant une production stable avant de générer un avis d’entretien, tandis qu’un bref changement au démarrage recevrait un traitement différent.
Il s’agit d’une politique de décision d’alerte, même si personne n’a programmé une règle API distincte pour chaque défaillance possible de la pompe.
Une étude de 2025 sur la détection d’anomalies en fermentation illustre cette distinction. Les chercheurs ont entraîné des modèles sur des lots en fonctionnement normal et utilisé des seuils fondés sur les percentiles pour déterminer quand les erreurs de reconstruction signalaient un comportement inhabituel.
Les modèles pouvaient repérer des écarts sans exemples étiquetés de chaque événement de contamination possible, mais ils avaient tout de même besoin d’un prétraitement, d’une configuration du modèle et de critères pour signaler les anomalies. Pour Leah, l’avantage est de pouvoir surveiller un comportement complexe sans décrire manuellement chaque défaillance potentielle.
Cette capacité dépend de ce que le modèle apprend comme étant normal.
 Offre aux lecteurs · jusqu’au 11 novembreOù se cache le coût dans votre usine?Regardez-la avec 3 mois de Premier gratuits →
Comment un modèle apprend le comportement normal de la production
Leah envisage d’abord d’envoyer tous les tags disponibles de l’historien à un détecteur d’anomalies. L’usine possède des années de données de production enregistrées, mais un grand ensemble de mesures ne constitue pas nécessairement une description fiable du fonctionnement normal.
Les dossiers historiques peuvent contenir des pannes, des cycles de nettoyage, des démarrages partiels, des mesures manquantes et des périodes où le procédé fonctionnait dans des conditions différentes. Entraîner le modèle sans discernement sur cet historique pourrait lui apprendre que le fonctionnement anormal est normal.
Un meilleur point de départ consiste à repérer les mesures qui décrivent le comportement attendu de la pompe et à établir les conditions dans lesquelles elles doivent être comparées.
Commencer avec les données existantes de l’API et de l’historien
Pour la pompe de transfert de jus, Leah commencerait par le courant du moteur, le débit, la pression de refoulement, la température du produit, la vitesse commandée et l’état de fonctionnement réel. Ensemble, ces mesures décrivent la charge de la pompe et la façon dont son comportement change avec le débit de production.
Elle les relierait aux renseignements du système de production, comme l’identité du produit, le numéro de lot, la recette, la vitesse de la ligne, les heures de démarrage et d’arrêt et l’état de nettoyage. Les dossiers d’entretien ajoutent une autre couche en indiquant quand la pompe a été inspectée, réparée ou remplacée, ce qui permet de comparer les comportements historiques inhabituels avec les constatations réelles des techniciens.
Une discussion d’avril 2026 entre praticiens des API illustre le problème de sélection des caractéristiques. Un participant travaillant avec plus de 150 caractéristiques industrielles décrivait la difficulté de trouver les variables pertinentes pour les décalages de mouvement, les cycles retardés et le comportement incohérent des capteurs.
Ce témoignage n’est pas une étude de rendement validée. Il illustre pourquoi l’ajout de signaux peut accroître la complexité sans améliorer l’information disponible pour prendre une décision.
Leah devrait sélectionner un groupe gérable de mesures pertinentes, confirmer leurs unités d’ingénierie et leurs horodatages, puis vérifier si leur qualité est suffisante. Dans la recherche de 2025 sur la fermentation, les chercheurs ont traité les horodatages invalides, les données manquantes, les mesures irrégulières et la construction des caractéristiques avant d’évaluer les modèles de détection.
Un modèle qui reçoit des mesures figées ou mal synchronisées pourrait produire un score d’anomalie impressionnant pour un problème d’instrumentation. Les vérifications de la qualité des capteurs doivent donc faire partie de la conception dès le départ.
Séparer les recettes, les vitesses, le NEP et les changements de format
La signature de fonctionnement de la pompe dépend de ce que l’usine produit. Par exemple, une réduction de la vitesse de la ligne de remplissage pourrait modifier les relations normales entre le débit et la charge du moteur sans indiquer une détérioration mécanique.
Si les états de production sont mélangés, le modèle pourrait signaler un comportement inhabituel chaque fois que l’usine change de produit.
Le nettoyage en place (NEP) crée un autre mode de fonctionnement distinct. Le débit, la température et les séquences d’équipement pendant le nettoyage diffèrent intentionnellement de ceux de la production. Une recherche publiée en 2018 a précisément examiné les anomalies dans les opérations de NEP d’un fermenteur de brasserie industrielle, montrant que les opérations de nettoyage peuvent être évaluées en fonction de leurs propres écarts plutôt que traitées comme de la production ordinaire.
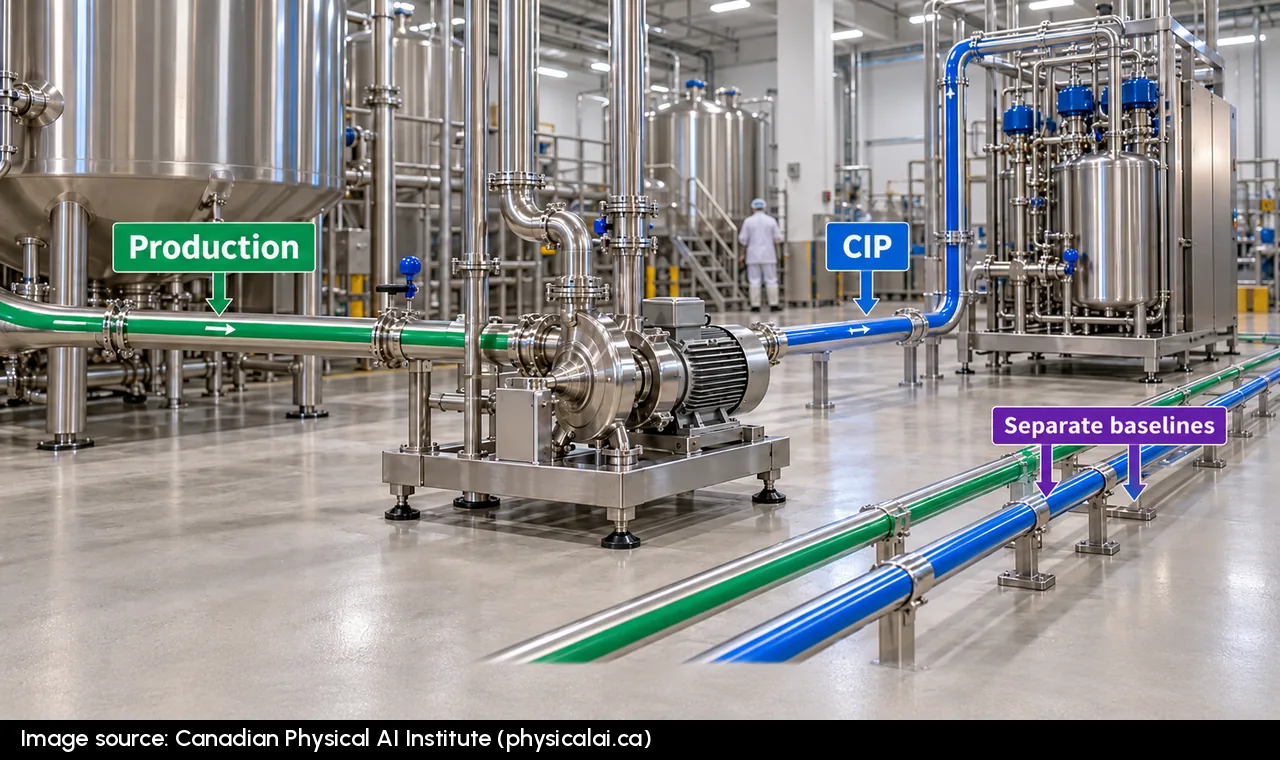
Leah devrait donc comparer le comportement de la pompe pendant le transfert de jus à une référence de production appropriée et évaluer les séquences de nettoyage par rapport à une référence de nettoyage. Son usine pourrait utiliser des références distinctes selon le mode de fonctionnement ou n’activer certaines détections que lorsque le procédé se trouve dans un état de marche validé.
Le même raisonnement s’applique aux changements de format d’emballage. Un arrêt temporaire pendant le réglage de l’équipement de manutention des bouteilles n’est pas automatiquement le signe d’une défaillance en développement.
Les usines qui ont de la difficulté à distinguer ces événements devraient d’abord examiner leur temps de changement de format et leurs dossiers, car des états de production mal définis nuisent autant aux rapports conventionnels qu’à la surveillance par apprentissage.
Choisir le modèle le plus simple qui répond à la question
Une fois les données appropriées réunies, Leah peut comparer les approches sans présumer que l’algorithme le plus complexe est le meilleur.
Une référence statistique pourrait suffire si le courant attendu de la pompe à chaque vitesse de fonctionnement suit une relation stable. L’analyse en composantes principales, ou ACP, peut aider à repérer des combinaisons inhabituelles parmi des mesures de procédé corrélées. Isolation Forest peut repérer des observations qui diffèrent de façon inhabituelle des combinaisons courantes dans des données de capteurs préparées.
Un autoencodeur peut apprendre à reconstruire des mesures normales et utiliser l’erreur de reconstruction pour signaler des écarts. Un modèle de prévision peut comparer la prochaine mesure attendue à ce qui se produit réellement, ce qui le rend utile pour certaines formes de dérive graduelle.
Ces approches de détection d’anomalies sont décrites dans la littérature générale sur la détection d’anomalies et la recherche industrielle sur les séries temporelles multivariées.
Leurs limites comptent autant que leurs capacités. Une approche statistique de base peut manquer des relations complexes, un autoencodeur peut repérer un écart important sans en expliquer la cause physique, et un modèle de prévision peut réagir à une transition opérationnelle légitime.
Leah devrait comparer les méthodes candidates à l’aide des données de sa propre usine, notamment en évaluant les fausses alertes et les éléments de preuve fournis pour l’enquête. Cette comparaison permet aussi de clarifier pourquoi la détection n’est pas la même chose que le diagnostic.
Quels problèmes de production la détection d’anomalies par IA peut-elle révéler ?
Les mesures de la pompe donnent à Leah un point de départ utile, mais une anomalie ne permet pas à elle seule d’établir si la cause est un problème de roue, une restriction, un changement d’ingrédient ou un capteur défectueux.
Une surveillance semblable peut aider à repérer des relations de fonctionnement inhabituelles dans d’autres équipements. Une remplisseuse peut présenter une variation inattendue du poids de remplissage, un échangeur thermique peut se comporter différemment dans des conditions de procédé comparables, et un équipement de réfrigération peut consommer davantage d’énergie par rapport à sa demande de fonctionnement.
L’IA peut repérer de tels écarts lorsque des mesures et des données de référence appropriées existent. Elle ne peut pas garantir un diagnostic précis ni un avertissement précoce pour chaque défaillance.
La différence entre détecter un écart et prédire la qualité est particulièrement importante en transformation alimentaire. Un modèle de prédiction de la qualité estime une propriété comme l’humidité, la densité ou le poids de remplissage. Un détecteur d’anomalies cherche à déterminer si le comportement actuel du procédé diffère du profil attendu.
Les deux peuvent appuyer de meilleures décisions, mais ils répondent à des questions différentes. Pour les procédés où les résultats de laboratoire arrivent après la décision de production, les capteurs logiciels par IA en fabrication alimentaire offrent une approche connexe. Cette distinction aide Leah à éviter de choisir un détecteur d’anomalies alors que son besoin réel est de prédire une mesure précise de la qualité.
Ce que montrent les données réelles des secteurs alimentaire et des boissons
Leah dispose de plusieurs exemples de recherche pour évaluer les affirmations faites au sujet du système proposé.
À l’usine de boissons de Britvic à Rugby, la surveillance de l’état a repéré un problème de pompe en développement que les techniciens ont pu corriger avant que la défaillance anticipée ne perturbe la production.
L’estimation déclarée par le fournisseur était d’environ 288 000 bouteilles de pertes de production évitées. Le guide existant du site sur la surveillance de l’état des pompes examine cet exemple dans le contexte du choix des premiers actifs à surveiller.
Il s’agit d’un exemple utile d’intervention d’entretien à la suite d’un avertissement, mais il ne vérifie pas indépendamment que les mêmes économies ou le même rendement d’alerte seraient obtenus dans l’usine de Leah.
La recherche fournit un autre type de preuve. Dans une étude de 2025 sur la coagulation du lait, les chercheurs ont combiné la spectroscopie Raman et la surveillance multivariée pour détecter des anomalies liées au contrôle de la température et à la concentration de présure.
Dans les conditions expérimentales étudiées, la précision de détection déclarée atteignait jusqu’à 99,8 %, avec un délai minimal de détection de sept minutes après l’ajout de présure. Ce résultat démontre une capacité de surveillance des procédés au-delà des équipements rotatifs, mais il n’établit pas le rendement du capital investi dans une laiterie commerciale, les taux de fausses alertes à long terme ou la conformité automatique en matière de salubrité alimentaire.
Une étude de 2024 sur une machine monobloc de l’industrie alimentaire fournit un autre exemple. Les chercheurs ont combiné des mesures de vibration et des dossiers d’arrêt de production pour évaluer des prédictions dans une fenêtre de trois minutes.
Ce travail utilisait la prédiction supervisée des arrêts, et non un détecteur d’anomalies entraîné uniquement sur des données normales. Il démontre néanmoins pourquoi il est important de relier les signaux des capteurs aux conséquences réelles sur la production.
Ensemble, ces exemples montrent que les méthodes apprises peuvent repérer des renseignements utiles sur les procédés ou les équipements que la surveillance conventionnelle ne rend pas nécessairement évidents. Ils ne prouvent pas que chaque usine obtiendra des avertissements utilisables ni que ces avertissements arriveront assez tôt pour modifier une décision d’entretien.
Cette incertitude devient plus sérieuse lorsque le système de contrôle existant produit déjà trop d’alarmes.
Pourquoi ajouter de l’IA à une usine submergée d’alarmes peut aggraver la situation
Avant d’introduire des notifications d’IA en temps réel, Leah examine l’historique actuel des alarmes de l’usine d’embouteillage. Elle veut savoir combien d’alarmes les opérateurs reçoivent déjà, lesquelles se répètent fréquemment et si chacune est associée à une réponse définie.
Sans cet examen, un nouveau système de détection d’anomalies pourrait augmenter le nombre d’avertissements sans améliorer la capacité de quiconque à y répondre.
Ce que disent ISA-18.2 et EEMUA 191 sur la charge d’alarmes
Le cadre de gestion des alarmes ANSI/ISA-18.2 établit un cycle de vie couvrant la philosophie d’alarme, l’identification, la rationalisation, la conception, l’exploitation, la surveillance, l’entretien, la gestion des changements et les audits.
La norme internationale correspondante, IEC 62682:2022, traite de la gestion des alarmes dans les industries de procédés, y compris les opérations continues, par lots et discrètes. Les deux cadres mettent l’accent sur les alarmes qui signalent des conditions nécessitant une réponse appropriée de l’opérateur.
La publication EEMUA 191, dont la quatrième édition a été publiée en 2024, fournit des recommandations industrielles supplémentaires sur la conception et la gestion des systèmes d’alarme.
Pour Leah, la question immédiate est de savoir si la charge actuelle d’alarmes est gérable. Les références de rendement couramment citées en gestion des alarmes par ISA servent de base à cet examen.
| Mesure de la charge d’alarmes | Valeur de référence courante | Signification pratique |
|---|---|---|
| Taux moyen souhaitable | Environ 1 alarme par opérateur toutes les 10 minutes | Référence pour un fonctionnement stable et gérable |
| Taux moyen plus élevé | Environ 2 alarmes par opérateur toutes les 10 minutes | Charge accrue, cible non privilégiée |
| Début d’une avalanche d’alarmes | Plus de 10 nouvelles alarmes en 10 minutes | Critère courant pour reconnaître une avalanche |
| Fin d’une avalanche d’alarmes | Moins de 5 nouvelles alarmes pendant une période subséquente de 10 minutes | Référence pour reconnaître le retour à la normale |
Il s’agit de références de rendement industrielles, et non de limites légales universelles pour les usines alimentaires canadiennes. Elles décrivent aussi le rendement formel d’un système d’alarme, et un avis d’entretien produit par l’IA n’est pas automatiquement une alarme de procédé formelle.
Des avis répétés peuvent tout de même interrompre les mêmes personnes responsables de la production, créant une charge de travail même lorsque les notifications arrivent par une interface distincte.
La leçon de l’avalanche d’alarmes de Milford Haven
Le risque de submerger les opérateurs n’est pas théorique.
Le 24 juillet 1994, une explosion et des incendies se sont produits à la raffinerie Texaco de Milford Haven, au pays de Galles. Le compte rendu de l’incident du Health and Safety Executive du Royaume-Uni a relevé plusieurs défaillances d’équipement, de système de contrôle et de gestion. Des alarmes d’urgence excessives ont réduit l’efficacité de la réponse des opérateurs, tandis que des vues d’ensemble inadéquates du procédé ont compliqué le diagnostic.
Les directives du régulateur sur la gestion des alarmes décrivent des opérateurs confrontés à un déluge d’alarmes pendant cinq heures avant l’incident.
Même s’il ne s’agissait ni d’un incident d’IA ni d’une usine de transformation alimentaire, la leçon s’applique à la décision de conception de Leah : davantage d’indications ne fournissent pas nécessairement de meilleurs renseignements lorsqu’un problème de procédé se développe.
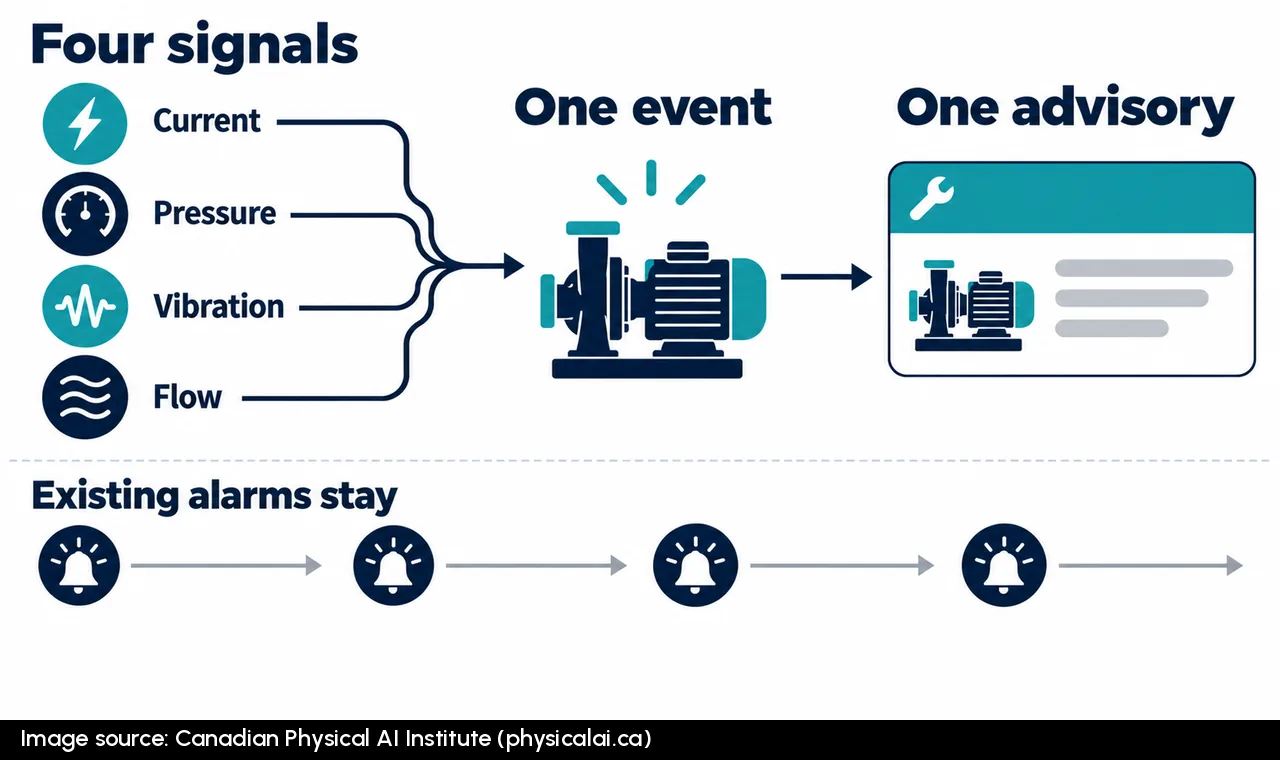
Si une pompe défaillante génère des avertissements d’IA distincts pour le courant, la pression, les vibrations et le débit, un opérateur pourrait recevoir quatre interruptions liées à un seul événement sous-jacent. Une meilleure approche consiste à regrouper les signaux connexes dans un seul constat qualifié et à l’acheminer à la personne capable de faire l’enquête.
Décider ce qui mérite une alarme destinée à l’opérateur
Leah établit une distinction claire entre les sorties que son système pourrait produire.
Une anomalie statistique peut demeurer une observation d’ingénierie. Un écart d’équipement persistant et explicable peut devenir un avis d’entretien, tandis qu’un constat nécessitant une inspection peut entrer dans le flux de travail d’entretien existant de l’usine.
Une indication qui exige réellement une action rapide de l’opérateur peut être admissible comme alarme de procédé formelle, mais seulement après l’examen nécessaire en gestion des alarmes.
Le système d’IA ne devrait pas supprimer de façon autonome les alarmes établies, les acquitter au nom d’un opérateur, modifier les interverrouillages de protection ou autoriser la libération d’un produit.
Une étude de 2017 dans une centrale thermique a déclaré avoir éliminé environ 98 % des occurrences d’alarmes intempestives sans affecter les vraies alarmes grâce à des techniques conventionnelles de nettoyage des alarmes. Même s’il s’agissait d’un secteur connexe plutôt que d’une mise en œuvre d’IA en usine alimentaire, le résultat confirme que la rationalisation des alarmes existantes peut résoudre certains problèmes de charge de travail de Leah plus directement qu’un autre modèle.
Une fois la responsabilité des alarmes et l’acheminement des notifications clarifiés, elle peut examiner les façons dont la surveillance par apprentissage elle-même pourrait échouer.
Comment les projets pilotes de détection d’anomalies échouent sur les données réelles de production
La première préoccupation de Leah est celle des faux positifs. Un détecteur peut reconnaître correctement un profil de mesures inhabituel et quand même générer une alerte sur laquelle personne ne devrait agir.
Les détections techniquement valides ne sont pas nécessairement des constats utiles pour l’entretien.
Les faux positifs consomment du temps d’inspection
Supposons que la pompe change de comportement pendant une transition normale de recette. Le modèle pourrait calculer un score d’anomalie élevé parce que le profil diffère des données de production stable, mais interrompre l’équipe d’entretien pour une transition qui ne nécessite aucune intervention reste une nuisance.
Une étude de 2026 sur les taux de faux positifs soutient que la fiabilité des détecteurs d’anomalies devrait être évaluée à l’aide du nombre absolu de faux positifs et des taux d’alarmes opérationnelles, et non de la seule exactitude de classification.
C’est la mesure dont Leah a besoin. Un détecteur qui produit peu de faux positifs en pourcentage de milliers d’observations de capteurs pourrait tout de même interrompre l’usine à répétition pendant chaque quart de travail.
Une discussion non vérifiée de janvier 2026 sur l’entretien industriel décrivait un projet pilote de surveillance extracôtière qui aurait émis des avertissements graves pendant des mois, alors que les inspections subséquentes n’avaient trouvé aucun défaut correspondant.
Ce témoignage ne permet pas d’établir un taux général d’échec de l’IA. Il illustre comment des avertissements répétés et non confirmés peuvent affaiblir la confiance et consommer les ressources d’entretien.
Les changements de recette et d’emballage créent une dérive du modèle
Les fausses alertes ne sont pas toujours causées par un modèle initial mal conçu. Parfois, le modèle devient désuet parce que le procédé change.
L’usine de Leah pourrait introduire une nouvelle formulation de jus, remplacer un composant de pompe, modifier un mécanisme de manutention des bouteilles ou changer les vitesses de fonctionnement. Une référence entraînée avant ces changements pourrait ne plus représenter un fonctionnement sain.
C’est ce qu’on appelle la dérive de concept. Une étude industrielle de 2024 portant sur une machine à tamis ultrasonique a examiné la détection d’anomalies dans des conditions changeantes et étudié l’apprentissage continu comme solution.
Le réentraînement automatique sur les données récentes introduit un autre risque. Si une pompe se détériore lentement, un modèle qui accepte continuellement tous les nouveaux comportements comme normaux pourrait apprendre la détérioration au lieu de la signaler.
Leah a donc besoin d’un processus contrôlé pour examiner et approuver les changements de modèle.
Les états manquants et les scores opaques minent la confiance
Un modèle qui ne sait pas quand l’usine est en nettoyage, en démarrage ou en changement de produit génèrera une incertitude évitable. Le problème peut être le manque de contexte plutôt que l’algorithme.
Dans une discussion de 2025 entre praticiens de la fabrication, des participants ont décrit des difficultés liées aux horodatages incohérents, aux états de machine absents et aux projets d’IA abandonnés parce que les opérateurs ne faisaient pas confiance aux résultats.
Il s’agissait d’expériences autodéclarées, et non de résultats de déploiement vérifiés de façon indépendante.
Une alerte qui indique seulement « score d’anomalie 0,94 » donne à Leah peu d’éléments pour décider si elle doit inspecter la pompe. Elle doit vérifier le constat à partir des connaissances du procédé et des dossiers historiques plutôt que de traiter le score comme un diagnostic.
Cette distinction devrait devenir une exigence formelle d’approvisionnement plutôt qu’une fonctionnalité de démonstration facultative.
Huit exigences indispensables avant de choisir un partenaire en détection d’anomalies par IA
Leah dispose maintenant de suffisamment de renseignements pour préparer une liste de contrôle d’acceptation technique pour l’usine fictive de l’Ontario. Cette liste vise à empêcher qu’une démonstration de modèle attrayante devienne un système de surveillance coûteux que l’usine ne peut ni exploiter, ni entretenir, ni utiliser en confiance.
Chaque exigence doit être démontrée dans les conditions propres à l’usine, et non simplement confirmée dans une présentation de vente.
1. Prouver que le système fonctionne en périphérie
La première exigence est le traitement local. Leah veut que la détection d’anomalies continue sur une infrastructure contrôlée par l’usine sans dépendre d’une connexion infonuagique externe.
Le fournisseur devrait démontrer que la collecte de données nécessaire, l’inférence, les notifications et la conservation des dossiers continuent lorsque les connexions Internet autorisées sont débranchées. Le système devrait obtenir les mesures de production au moyen d’une intégration approuvée en lecture seule plutôt que d’exiger un accès sans restriction aux commandes des API.
Cela reflète les considérations de fiabilité et de sécurité des directives de NIST sur la sécurité des technologies opérationnelles.
Un déploiement en périphérie n’est pas automatiquement sécurisé. La segmentation du réseau, le contrôle d’accès, les mises à jour et le soutien à distance doivent quand même être examinés.
Le test d’acceptation consiste à vérifier si l’usine conserve la maîtrise des opérations de surveillance lorsque la connectivité externe est indisponible.
2. Définir clairement la propriété des données et les droits de collecte
Le traitement local n’empêche pas automatiquement la collecte externe.
Leah a besoin de conditions contractuelles qui précisent la propriété des mesures brutes, des caractéristiques dérivées, des sorties du modèle, de l’historique des alertes et des dossiers exportés. L’entente devrait interdire la collecte, la conservation ou la réutilisation non autorisée des données de production, y compris l’entraînement de modèles pour d’autres clients.
Les recettes, les horaires de fonctionnement et le comportement de l’équipement peuvent révéler des renseignements commercialement sensibles. Une discussion de 2026 entre praticiens canadiens des systèmes SCADA a soulevé des préoccupations semblables concernant l’accès externe, la conservation des données et les connexions à distance.
Cette discussion relève de l’opinion de praticiens, et non de directives juridiques canadiennes. Les directives du Commissariat à la protection de la vie privée du Canada sur les tiers traitent de la responsabilité lorsque des renseignements personnels sont traités par des fournisseurs de services, mais elles n’établissent pas de règle générale exigeant que toute la télémétrie industrielle demeure au Canada.
Pour Leah, le maintien des données de l’usine sur place est une exigence d’approvisionnement qui doit être inscrite au contrat et vérifiée techniquement.
3. Exiger le contrôle des versions du modèle et la restauration
La question suivante est de savoir ce qui se passe après que le système de surveillance a fonctionné avec succès.
Supposons que Leah approuve un nouveau modèle après le remplacement d’une pompe et que le modèle mis à jour commence soudainement à générer des avertissements fréquents. Le système doit lui permettre d’identifier la version du modèle responsable, de comparer son comportement à celui de la version précédente et de restaurer la configuration approuvée antérieure.
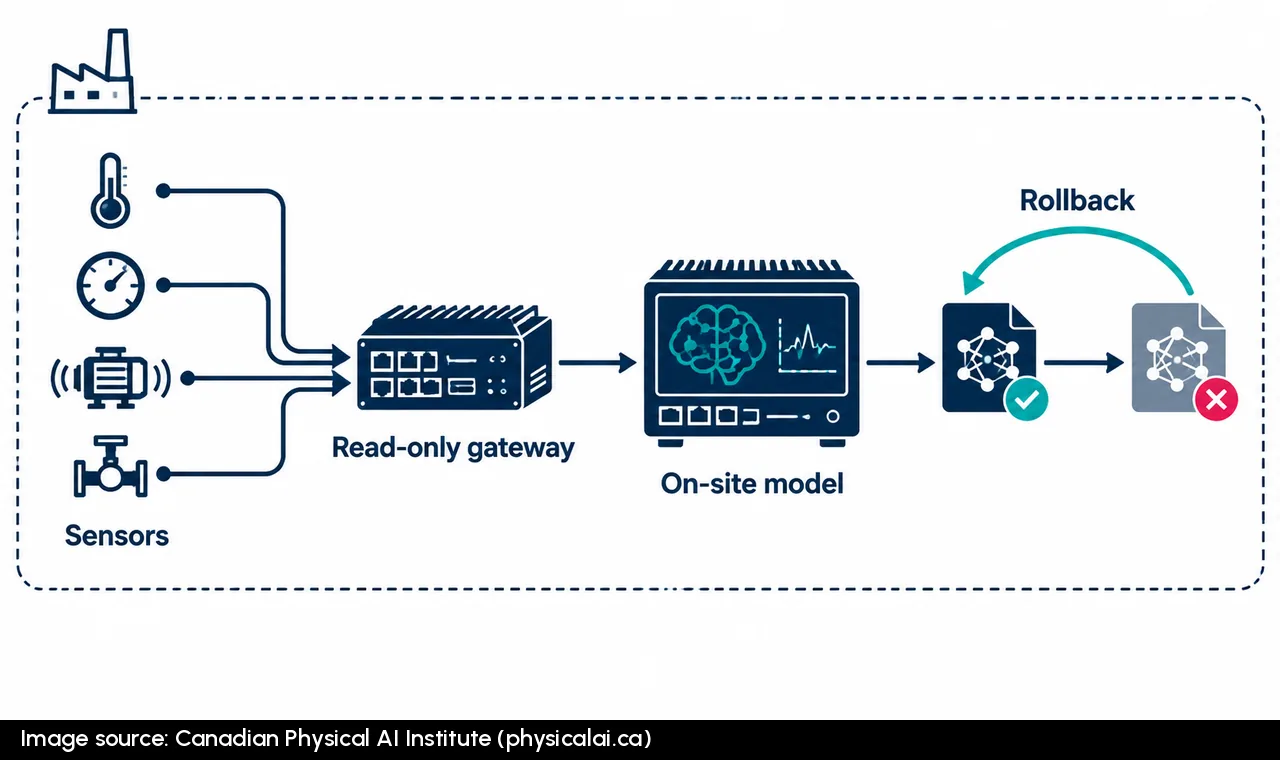
Cela exige de conserver les versions du modèle, de documenter les paramètres d’alerte, d’approuver les changements et de tester une procédure de restauration. Sans cette possibilité, une mise à jour du modèle peut devenir un problème de soutien à la production plutôt qu’une amélioration contrôlée.
Le fournisseur devrait démontrer tout le processus pendant les essais d’acceptation, y compris le rétablissement après l’introduction délibérée d’une mauvaise configuration.
4. Montrer quels tags ont déclenché chaque alerte
Leah n’approuvera pas un système qui ne signale qu’un score d’anomalie.
Pour chaque constat exploitable, elle a besoin de l’identité de l’équipement, du mode de production, des tags touchés, des valeurs réelles, du comportement attendu et de la durée pendant laquelle l’écart s’est développé.
L’affichage devrait permettre de distinguer une relation courant-débit modifiée d’un capteur manquant ou figé. La recherche sur la maintenance prédictive industrielle interprétable appuie le fait de relier les constats analytiques à des caractéristiques de production mesurables.
L’explication n’a pas besoin d’affirmer une cause fondamentale définitive. Elle doit fournir au technicien suffisamment de preuves pour choisir une étape de vérification raisonnable.
5. Relier les constats qualifiés aux flux de travail existants d’alarmes et de GMAO
Une alerte qui reste sur un tableau de bord distinct pourrait ne jamais modifier une décision d’entretien. Leah exige donc un chemin explicite entre l’observation de l’IA et le processus établi de l’usine.
Un avis qualifié concernant la pompe pourrait générer une tâche d’examen d’entretien. Un technicien confirmerait le constat, le rejetterait ou le ferait passer à l’entretien planifié, tout en conservant les données d’anomalie initiales et le résultat final de l’inspection.
Les alarmes formelles destinées aux opérateurs doivent continuer de suivre la philosophie d’alarme du site et les procédures d’approbation établies. Cette séparation empêche chaque écart statistique de devenir une autre alarme à l’interface opérateur, tout en veillant à ce que les constats utiles ne disparaissent pas.
6. Attribuer la responsabilité du réentraînement après les changements de procédé
L’usine de Leah modifie régulièrement les recettes, les formats d’emballage et les réglages de l’équipement. Chaque changement soulève une question : la référence actuelle demeure-t-elle valide ?
L’entente avec le fournisseur doit préciser qui évalue cette question, qui prépare les mises à jour du modèle, qui vérifie le modèle révisé à l’aide d’incidents antérieurs et qui autorise le déploiement.
La procédure devrait également préciser ce qui se passe lorsque la personne responsable n’est pas disponible ou que la relation avec le fournisseur prend fin. Sans responsabilité attribuée, les changements courants de production peuvent graduellement rendre le système de surveillance peu fiable.
7. Exiger un rétrotest sur les incidents de l’usine
Les résultats génériques d’exactitude ne suffisent pas. Leah veut que le système proposé soit évalué par rapport aux problèmes de pompe consignés, aux dates de réparation, aux interruptions de production et aux alarmes disponibles à l’époque.
Le test doit établir quand le modèle aurait émis un avertissement, quels événements il aurait manqués et si l’avertissement aurait précédé l’alarme existante d’assez longtemps pour permettre une intervention utile.
La recherche sur l’évaluation de la maintenance prédictive non supervisée souligne les limites des mesures d’anomalie conventionnelles et la nécessité d’évaluer des événements significatifs plutôt que de simples points de données anormaux.
Si le modèle ne repère que les problèmes que le système existant révèle déjà, sa valeur ajoutée est limitée.
8. Convenir avec les opérateurs d’un budget de fausses alertes
Même un détecteur techniquement performant peut échouer si l’usine ne peut pas gérer sa charge de notifications.
Leah doit convenir avec les équipes des opérations et de l’entretien du nombre acceptable de fausses alertes ou d’alertes non exploitables par quart de travail, du temps d’enquête prévu et de la procédure d’escalade. Le budget doit être testé pendant la production normale, le NEP, les démarrages et les changements de produit.
La recherche examinée n’établit aucun taux universel acceptable de fausses alertes par IA pour les usines alimentaires. L’usine doit décider de ce qui est gérable selon les effectifs, les risques du procédé et la valeur des avertissements potentiels.
La liste de contrôle relie le rendement du modèle aux personnes censées l’utiliser. L’étape suivante consiste à tester ces exigences avant d’installer des notifications en direct.
Un plan de projet pilote pratique pour une usine alimentaire canadienne
Le projet pilote de Leah devrait répondre à une question : le détecteur proposé peut-il repérer un problème de production important plus tôt ou plus clairement que les contrôles existants de l’usine, tout en imposant une quantité acceptable de travail supplémentaire ?
Elle ne devrait pas commencer par surveiller tous les actifs. Elle choisit plutôt la pompe de transfert parce qu’elle possède un historique exploitable, des interruptions connues et une équipe d’entretien capable d’intervenir.
Étape 1 : Définir la défaillance et recueillir les preuves
Leah commence par les interruptions documentées de la pompe et son historique d’inspection. Elle repère les mesures pertinentes de l’historien, les états de l’équipement, les dossiers de recette, les horodatages des alarmes existantes et les constats d’entretien.
L’objectif est d’établir la référence réelle de l’usine. Pour chaque incident connu, elle consigne ce qui s’est produit, à quel moment le problème a été reconnu, quelle action a été prise et si la production a été perdue.
Cela évite de compter une alerte de l’IA comme utile lorsque l’inspection courante ou le système d’alarme existant avait déjà repéré le problème.
Étape 2 : Entraîner et tester dans l’ordre chronologique
Leah sépare les données de production antérieures utilisées pour développer le modèle des dossiers plus récents utilisés pour l’évaluer. Le modèle ne devrait pas apprendre à partir d’événements futurs qui auraient été inconnus au moment où l’avertissement était censé être généré.
Elle rejoue ensuite les données d’évaluation dans l’ordre chronologique. Le test comprend le fonctionnement sain, les problèmes connus de la pompe, différentes recettes de jus, les périodes de démarrage et le NEP.
Pour chaque alerte candidate, l’équipe consigne si la détection correspondait à un problème significatif, à quel moment elle est survenue et si une intervention d’entretien aurait été possible. L’évaluation doit également relever les incidents manqués et les notifications fausses ou non exploitables.
Étape 3 : Exécuter le système en mode silencieux avant les alertes en direct
Après les essais historiques, le modèle fonctionne sur les données actuelles de production sans interrompre les opérateurs. Leah examine les détections avec les responsables de l’entretien et de la production et consigne leurs décisions.
Pour une évaluation plus large de l’état de préparation au déploiement, l’usine peut aussi utiliser la liste de contrôle du site pour la préparation des projets pilotes d’IA, qui traite des responsabilités opérationnelles lorsqu’un système d’IA se trompe.
Le projet pilote devrait se conclure par une décision écrite de déployer, de réviser ou d’arrêter. Une bonne démonstration ne suffit pas à justifier une expansion.
Exemple détaillé : l’avertissement précoce justifie-t-il les alertes supplémentaires ?
Leah a besoin d’une façon compréhensible de présenter les résultats du projet pilote à la direction. Les nombres suivants sont entièrement illustratifs. Ils ne représentent ni un résultat mesuré dans une usine alimentaire ni une référence de l’industrie.
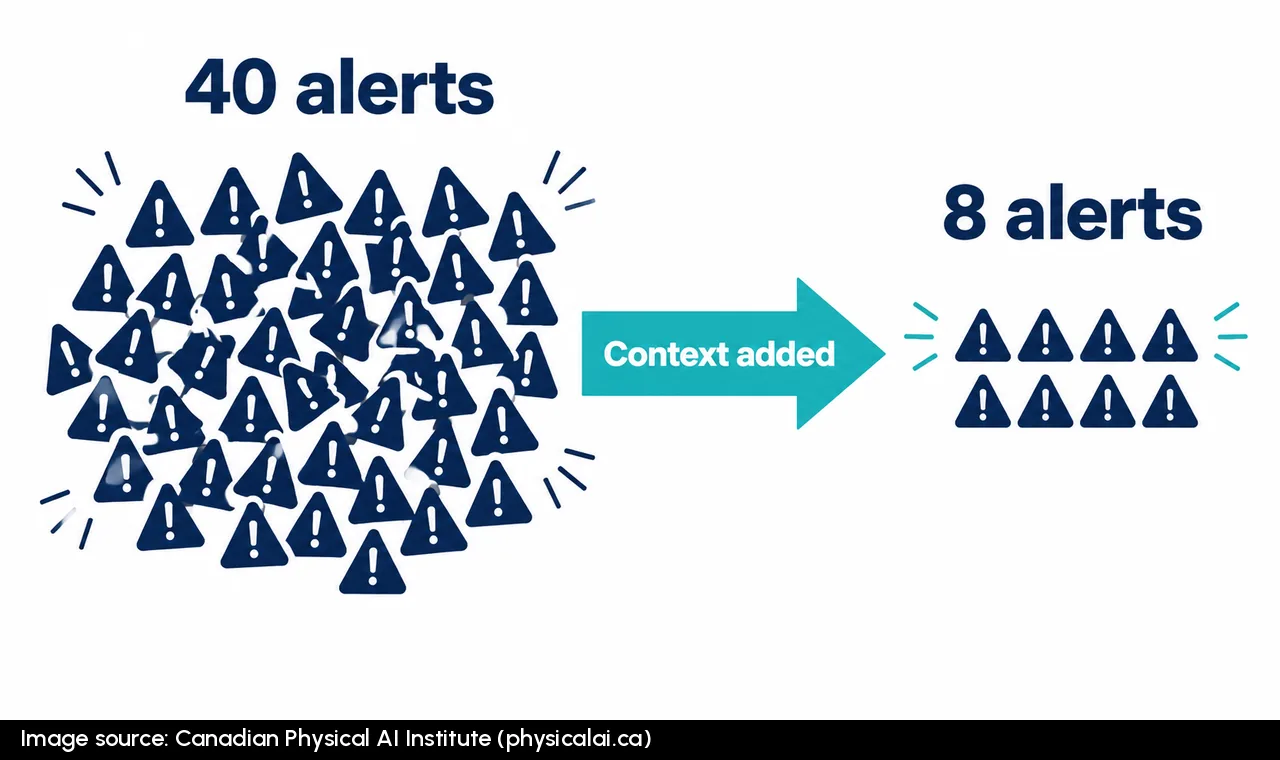
Supposons que l’usine de l’Ontario évalue son détecteur d’anomalies pendant 20 quarts de travail. Leah compare la configuration initiale à une version révisée qui utilise un meilleur contexte de recette et de mode de fonctionnement.
Le tableau montre le nombre de notifications obtenu, les constats confirmés et le temps d’examen.
| Mesure illustrative | Configuration initiale | Configuration révisée |
|---|---|---|
| Quarts de travail évalués | 20 | 20 |
| Nombre total d’alertes | 40 | 8 |
| Constats utiles confirmés | 4 | 3 |
| Alertes non exploitables | 36 | 5 |
| Alertes non exploitables par quart de travail | 1,8 | 0,25 |
| Temps d’examen par alerte non exploitable | 10 minutes | 10 minutes |
| Temps total d’examen des alertes non exploitables | 6 heures | 50 minutes |
La configuration révisée réduit considérablement le temps d’enquête inutile, mais elle produit aussi un constat confirmé de moins. Leah ne peut pas déclarer la révision réussie sans vérifier quel événement a été manqué et si cette omission était acceptable.
Supposons maintenant qu’une alerte de pompe confirmée survienne trois heures avant le déclenchement prévu de l’alarme de courant élevé existante. Cela représente trois heures d’avertissement précoce potentiel, et non trois heures d’arrêt automatiquement évité.
L’équipe d’entretien doit encore vérifier la condition, déterminer une réponse appropriée et organiser une intervention avant les conséquences sur la production. Une deuxième alerte qui arrive quelques instants seulement avant un arrêt peut être techniquement correcte, mais opérationnellement trop tardive.
Leah consigne donc à la fois le délai d’avertissement et le temps d’intervention réalisable. Un modèle qui repère les problèmes tôt, mais ne permet pas d’intervenir, peut avoir une valeur économique limitée. Un modèle qui fournit un délai d’avertissement plus utile avec moins d’interruptions inutiles est un meilleur candidat.
L’analyse de rentabilité doit traduire cette distinction en un calcul des coûts défendable.
Calculer la valeur commerciale sans compter chaque anomalie comme une économie
Pour la direction, Leah sépare le rendement technique de la valeur financière. Une détection par IA n’est pas la même chose qu’une défaillance évitée, et une défaillance évitée n’équivaut pas automatiquement à la valeur complète de la production planifiée.
Le calcul devrait identifier la perte qui se serait réellement produite sans l’intervention précoce.
Une équation pratique pour l’analyse de rentabilité est :
Valeur incrémentale nette = pertes supplémentaires évitées et vérifiées, moins les coûts d’inspection et d’intervention, les coûts de surveillance et d’intégration, ainsi que les coûts permanents du modèle et du soutien.
Le coût d’un projet pilote dépend de l’état des capteurs et des tags, du matériel en périphérie, des efforts d’intégration et de la période de validation. Avant de comparer les propositions, demandez aux fournisseurs de distinguer les coûts ponctuels du matériel et de l’intégration des coûts récurrents des logiciels, du soutien et de la gouvernance des modèles.
Les pertes évitées peuvent comprendre la production irrécupérable, le gaspillage de produits, le NEP supplémentaire, les frais de réparation d’urgence ou d’autres conséquences documentées. La production qui peut être récupérée plus tard ne devrait pas automatiquement être évaluée comme une production définitivement perdue.
Le guide du site sur le coût des arrêts de production fournit un cadre pour distinguer la production contrainte des situations où la capacité disponible modifie les conséquences financières.
Leah devrait également inclure le coût de l’examen des fausses alertes. Un avertissement qui exige des inspections inutiles consomme du temps de technicien, même si l’usine ne subit jamais d’arrêt de production.
Pour le contexte canadien, l’annonce de projet de NGen sur la transformation alimentaire décrit une collaboration de 3 millions de dollars canadiens portant sur l’analytique avancée, la productivité et la surveillance de l’énergie.
Cela confirme qu’il existe des activités canadiennes en analytique manufacturière, mais ne fournit pas de résultats de rendement du capital investi ni de fausses alertes vérifiés de façon indépendante pour le type de détecteur d’anomalies que Leah évalue. Sa proposition à la direction devrait présenter séparément les constats locaux démontrés et les économies annuelles projetées.
Une fois les limites financières établies, plusieurs questions techniques courantes restent à clarifier.
Foire aux questions sur la détection d’anomalies par IA en fabrication
Les équipes d’usine qui évaluent la détection d’anomalies utilisent souvent les mêmes termes pour désigner des problèmes techniques et opérationnels différents. Ces réponses clarifient les distinctions pertinentes pour le système de surveillance proposé par Leah.
Quels sont les trois types d’anomalies ?
Trois catégories d’anomalies couramment décrites sont les anomalies ponctuelles, contextuelles et collectives.
Une anomalie ponctuelle est une observation individuelle qui diffère considérablement des valeurs habituelles.
Une anomalie contextuelle est inhabituelle seulement dans certaines conditions, par exemple un courant de pompe autrement acceptable à une vitesse de ligne inattendue.
Une anomalie collective est un profil ou une séquence inhabituelle même si ses mesures individuelles semblent acceptables.
La détection d’anomalies est-elle non supervisée ?
Pas nécessairement.
Les méthodes non supervisées repèrent les profils inhabituels sans exiger que chaque observation porte une étiquette de défaillance.
Les méthodes entraînées uniquement sur des données normales ou semi-supervisées apprennent à partir de données censées représenter un fonctionnement sain.
Les méthodes supervisées utilisent des exemples étiquetés de défaillances ou de résultats connus.
Quelles sont les techniques courantes de détection d’anomalies ?
Les approches courantes comprennent les références statistiques, l’ACP, Isolation Forest, One-Class SVM, les autoencodeurs et la prévision de séries temporelles.
Elles diffèrent par leurs exigences en matière de données, leur sensibilité au contexte de fonctionnement et leur capacité à expliquer une détection. La technique appropriée dépend des signaux disponibles, du comportement du procédé et du niveau d’explication requis, plutôt que de la seule sophistication de l’algorithme.
Quelle est la différence entre la détection d’anomalies et la détection de valeurs aberrantes ?
La détection de valeurs aberrantes repère généralement des observations individuelles qui diffèrent de façon inhabituelle des autres observations. La détection d’anomalies est un concept plus large qui peut aussi examiner le contexte de fonctionnement et les séquences dans le temps.
Par exemple, une seule lecture de courant moteur exceptionnellement élevée peut être une valeur aberrante, tandis qu’une séquence de mesures inhabituelles peut indiquer un écart de procédé nécessitant un examen plus approfondi.
Pouvez-vous donner un exemple de détection d’anomalies ?
La pompe fictive de Leah en est un exemple. Un détecteur repère un écart par rapport au comportement historiquement sain de la pompe et crée un avis d’entretien.
L’avis déclenche une vérification. Il n’établit pas automatiquement la cause fondamentale ni n’exige l’arrêt de la pompe.
Quelle est la différence entre une fausse alarme et une alarme intempestive ?
Une fausse alarme indique une condition qui n’est pas réellement présente.
Une alarme intempestive crée une interruption inutile ou offre peu de mesures opérationnelles utiles, même si la mesure qui l’a déclenchée est techniquement correcte. Une alarme répétée qui oscille autour de sa limite peut également devenir intempestive.
Leah devrait mesurer si les alertes entraînent une action appropriée, et non simplement si un écart mathématique s’est produit.
Qu’est-ce que la gestion des alarmes ?
La gestion des alarmes est le processus systématique qui consiste à définir, concevoir, exploiter, examiner et améliorer les alarmes afin que les opérateurs reçoivent des renseignements pertinents qui exigent une réponse appropriée.
ISA-18.2 et IEC 62682 fournissent des cadres de cycle de vie pertinents.
Quels sont des exemples de méthodes de surveillance de la salubrité alimentaire ?
Les usines alimentaires utilisent des mesures de procédé établies, des inspections, des dossiers et des procédures de contrôle vérifiées pour appuyer la surveillance de la salubrité alimentaire. Selon le procédé, elles peuvent comprendre la surveillance de la température, la détection des métaux, la vérification de l’assainissement et les contrôles de qualité.
La détection d’anomalies par IA peut fournir des renseignements supplémentaires sur les comportements inattendus d’un procédé, mais elle ne devrait pas remplacer de façon autonome les contrôles validés de salubrité alimentaire ni les décisions établies de libération par l’assurance qualité.
Une anomalie peut justifier une enquête, mais elle n’établit pas à elle seule si un produit est sûr ou dangereux.
La première étape pratique : prouver l’utilité d’un seul avertissement
La prochaine décision de Leah consiste à déterminer si le projet pilote sur la pompe démontre un délai d’avertissement utile, une charge de fausses alertes gérable et une valeur ajoutée crédible.
Si les preuves justifient une expansion, elle peut passer à un autre actif présentant des défaillances documentées et un responsable clairement désigné pour intervenir. Si le modèle ne peut pas améliorer la surveillance existante sans créer du travail inutile, elle devrait réviser ou arrêter le projet pilote plutôt que de procéder à un déploiement dans toute l’usine.